ระบบ Monitoring Solar Farm: จาก Inverter, Data Logger ถึง PR และ Alarm.
อธิบายสถาปัตยกรรมระบบ Monitoring Solar Farm ตั้งแต่ Inverter, Meter, Weather Sensor, Data Logger, Modbus, Network, Historian/Cloud ไปจนถึง Performance Ratio, Availability และ Alarm Workflow
ระบบ Monitoring Solar Farm ไม่ใช่แค่หน้า Dashboard ดูว่าผลิตไฟได้กี่ kWh แต่เป็น data pipeline ที่เชื่อม อุปกรณ์ภาคสนาม → Data Logger/Gateway → Network → Historian/Cloud/SCADA → KPI/Alarm/Workflow เข้าด้วยกัน
ระบบที่ดีช่วยให้ทีม O&M รู้ว่าอะไรเกิดขึ้น ที่ไหน และเมื่อไร แต่ Monitoring เองไม่ใช่คำรับประกันผลตอบแทนการลงทุน และไม่สามารถแก้ปัญหา engineering/O&M ที่ไม่มี process รองรับได้
แหล่งอ้างอิงหลักสำหรับแนวคิด monitoring performance คือ IEC 61724-1:2021 — Photovoltaic system performance — Part 1: Monitoring ร่วมกับเอกสารผู้ผลิตของอุปกรณ์ที่ใช้จริง
1. เริ่มจากคำถามว่า “ต้องตัดสินใจอะไรจากข้อมูลนี้”
ก่อนเลือก Platform ควรกำหนด use case:
- ตรวจว่า inverter/string/plant online หรือไม่
- รู้ production loss เมื่อเทียบกับ irradiance
- หา alarm ที่ต้องเข้า site
- ติดตาม meter/import/export
- เทียบ plant performance ระหว่างวัน/เดือน
- วิเคราะห์ soiling/shading/temperature effect
- ตรวจ data gap / sensor failure
- สร้าง evidence สำหรับ O&M/SLA
ถ้าไม่รู้ว่าจะใช้ข้อมูลตัดสินใจอะไร ระบบมักจบด้วย Dashboard สวยแต่ไม่มี operational workflow
2. Field Data: ข้อมูลต้องมาจากหลายแหล่ง
ข้อมูลสำคัญอาจมาจาก:
Inverter
- DC voltage/current
- AC power/energy
- MPPT/string data ตามรุ่น
- temperature
- operating state
- alarm/event
Revenue / Grid Meter
ใช้ยืนยัน energy flow ที่ PCC หรือ meter point ตาม system design ไม่ควรเอา inverter production ไปใช้แทน meter ทุกกรณี
Weather / Irradiance Sensor
เช่น:
- plane-of-array irradiance
- ambient temperature
- module temperature
- wind data ตาม monitoring class/use case
ข้อมูล irradiance สำคัญเมื่อต้องการแยกว่า “ผลิตน้อยเพราะแดดน้อย” หรือ “ผลิตน้อยกว่าที่ควรเมื่อเทียบกับทรัพยากรแสง”
3. Data Logger / Gateway คือจุดรวมข้อมูล
ไซต์ขนาดกลาง/ใหญ่มีอุปกรณ์หลาย protocol และหลาย vendor จึงมักมี Data Logger หรือ Gateway เป็น edge layer
ตัวอย่าง flow:
Inverters / Meter / Weather Sensors
          │
     RS485 / Ethernet
     Modbus / Vendor protocol
          │
          ▼
   Data Logger / Gateway
          │
    LAN / Fiber / Cellular
          │
          ▼
 Historian / SCADA / Cloud
Data Logger ที่ดีควรจัดการอย่างน้อย:
- device polling
- timestamp
- local buffering เมื่อ uplink ขาด
- protocol mapping
- communication alarms
- controlled northbound interface
ตัวอย่างอุปกรณ์ใน ecosystem Huawei: SmartLogger3000A
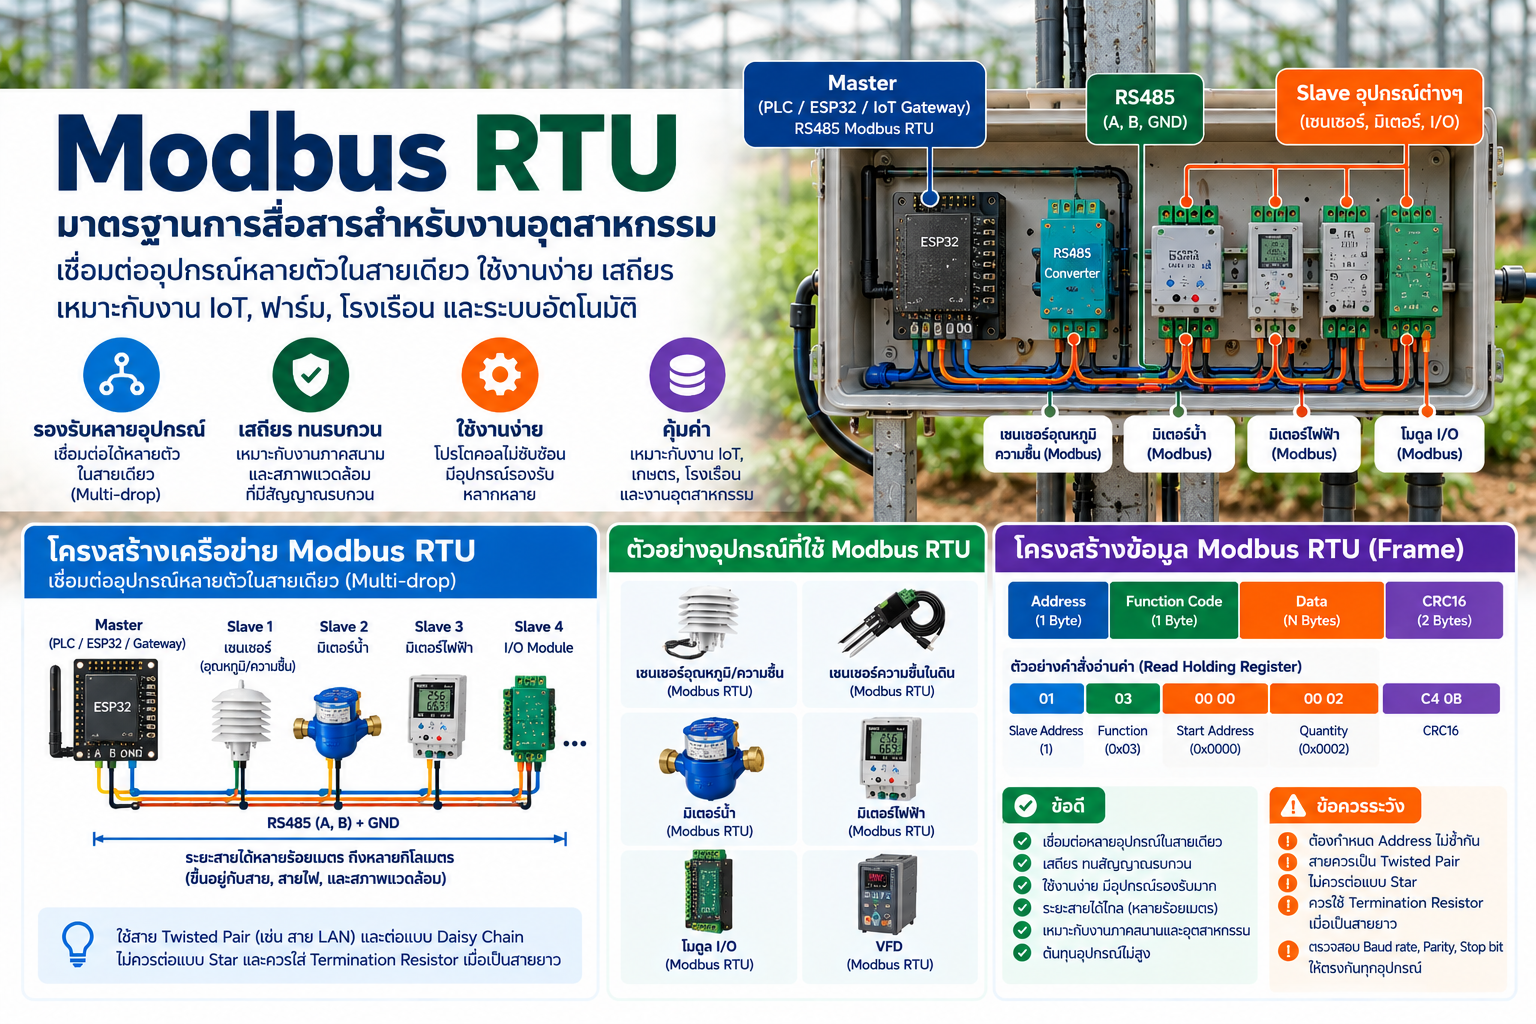
4. Modbus เป็น Field Integration ที่พบบ่อย
Meter, inverter, weather device และ PLC จำนวนมาก expose ข้อมูลผ่าน Modbus RTU/TCP
แต่การดึง register มาได้ไม่ได้แปลว่าข้อมูลพร้อมใช้ทันที ต้อง normalize:
- unit
- scale
- signed/unsigned
- word order
- timestamp
- quality flag
- model/firmware revision
อ่านต่อ: Modbus คืออะไร
5. Network ต้องออกแบบให้ Monitoring ไม่หายพร้อม Internet
Solar Farm ที่อยู่ห่างไกลอาจใช้:
- fiber
- Ethernet
- cellular uplink
- site VPN
- redundant communication ในงานที่ต้องการ availability สูง
หลักสำคัญคือ Internet outage ไม่ควรทำให้ข้อมูลทั้งหมดสูญหาย ถ้าระบบต้องการย้อนหลัง
ควรมี local buffering / retry และรู้ด้วยว่า buffer เก็บได้กี่ชั่วโมงหรือกี่วัน
6. Historian กับ Dashboard ทำคนละหน้าที่
Dashboard คือ presentation ส่วน Historian/Database คือ evidence layer
ระบบควรตอบได้ว่า:
- raw data เก็บนานเท่าไร
- aggregation 1/5/15 นาทีทำอย่างไร
- timezone/DST ใช้อะไร
- missing sample ถูก mark หรือเติมศูนย์
- export raw data ได้หรือไม่
- API มี rate/permission อย่างไร
อย่าให้กราฟบน Cloud เป็น “ข้อมูลชุดเดียวที่มี” โดยไม่มี export/ownership plan
7. ทำ Data Contract ก่อนทำ Dashboard รวมหลาย Vendor
ถ้าจะรวม Huawei, Hoymiles, Solis, Deye, Fox ESS หรือระบบอื่นไว้ในแพลตฟอร์มเดียว ควรกำหนด schema กลางก่อน ไม่ควรปล่อยให้ชื่อ field ของแต่ละ Cloud ไหลเข้าฐานข้อมูลตรง ๆ
ข้อมูล telemetry หนึ่ง record ควรตอบได้อย่างน้อย:
site / asset / metric
value + unit
measurement_time
received_time
quality: valid | suspect | stale | missing
source / connector
model + firmware/API version เมื่อเกี่ยวข้อง
measurement_time กับ received_time ต้องแยกกัน เพราะข้อมูลที่ถูก buffer ระหว่าง Internet ล่มอาจมาถึงช้ากว่าเวลาที่วัดจริงหลายชั่วโมง ถ้าใช้เวลา ingest แทนเวลา measurement กราฟ, KPI และ Alarm จะตีความเหตุการณ์ย้อนหลังผิดลำดับ
ควรแยกข้อมูลออกเป็นอย่างน้อย 3 กลุ่ม:
| กลุ่ม | ตัวอย่าง | Cadence |
|---|---|---|
| Asset inventory | Plant, inverter, logger, meter, serial/model | เปลี่ยนไม่บ่อย |
| Telemetry | kW, kWh, voltage, SOC, irradiance | time-series |
| Event/Alarm | code, severity, first-seen, cleared | event-driven |
การแยกแบบนี้ทำให้ Collector sync asset inventory ช้ากว่า telemetry ได้ และไม่ต้องดึงข้อมูลทุกอย่างด้วย cadence เดียวกัน
8. Performance Ratio (PR) ต้องมี Measurement Context
PR ใช้เปรียบเทียบ output ของ PV system กับ reference yield ที่สัมพันธ์กับ irradiance แต่ค่าที่เชื่อถือได้ต้องเริ่มจาก sensor, sampling และ data-quality ที่เหมาะสม
PR ไม่ใช่เปอร์เซ็นต์ “ประสิทธิภาพ inverter” และไม่ควรใช้ตัวเลขเดียวตัดสิน plant โดยไม่ดู:
- irradiance sensor location/class
- temperature
- availability
- curtailment
- grid outage
- clipping
- data gaps
- maintenance periods
มาตรฐาน IEC 61724-1 แยก monitoring requirement ตาม class/use case เพื่อให้ measurement quality สอดคล้องกับวัตถุประสงค์
9. Availability ต้องนิยามก่อนคำนวณ
คำว่า Availability อาจหมายถึง:
- inverter availability
- plant availability
- contractual availability
- time-based availability
- energy-weighted availability
แต่ละนิยามตอบคำถามต่างกัน
ถ้าจะใช้ KPI กับ SLA/O&M contract ต้องเขียน definition, exclusions และ data source ชัด ไม่ใช่เอาค่า default จาก Dashboard ไปใช้ในสัญญาโดยตรง
10. Alarm ที่ดีต้องไปถึง Action
ระบบที่มี alarm หลายพันรายการแต่ไม่มี triage ไม่ได้ช่วย O&M มากนัก
Alarm workflow ควรมี:
- severity
- affected asset
- first-seen / last-seen
- acknowledgement
- ownership
- recommended diagnostic evidence
- escalation
- closure/root cause
ควรแยก communication loss ออกจาก equipment fault เพราะการที่ logger อ่าน inverter ไม่ได้ไม่ได้แปลว่า inverter หยุดผลิตเสมอไป
11. Investor / Owner ควรถามเรื่อง Data Ownership
ก่อนรับมอบระบบ ควรถาม:
- owner เข้าถึง raw data ได้หรือไม่
- export เป็น CSV/API ได้หรือไม่
- เปลี่ยน O&M vendor แล้วข้อมูลเดิมยังอยู่หรือไม่
- credential/account ownership เป็นของใคร
- cloud subscription หมดแล้วเกิดอะไรขึ้น
- retention policy เท่าไร
- vendor lock-in มีตรงไหน
นี่เป็นประเด็นที่มีผลต่อ asset operation ระยะยาวมากกว่า feature Dashboard บางรายการ
12. Monitoring ไม่ใช่ Investment Guarantee
บทความ Solar.Farm เดิมมีถ้อยคำเรื่อง passive income, project failure และตัวเลข loss/รายได้แบบกว้างเกินหลักฐาน จึงไม่ถูกย้ายมา
Monitoring ช่วยให้ มองเห็นและตอบสนองต่อปัญหา ได้ดีขึ้น แต่ผลตอบแทนยังขึ้นกับ:
- EPC quality
- energy yield
- tariff/PPA
- financing
- curtailment
- O&M
- equipment reliability
- land/grid constraints
ข้อมูล Monitoring เป็นเครื่องมือบริหารความเสี่ยง ไม่ใช่หลักประกันผลกำไร
13. Architecture ที่เหมาะกับ Thospaak direction
สำหรับระบบ engineering platform แนวทางที่น่าสนใจคือแยกชั้นชัดเจน:
Field Devices
→ Vendor-neutral Edge Adapter
→ Normalized time-series model
→ Storage
→ Rules / Alarm
→ Dashboard / API / Apps
วิธีนี้ทำให้ระบบไม่ผูก logic ทั้งหมดกับ Cloud ของ inverter รายเดียว และสามารถเชื่อม Home Assistant, SCADA หรือ custom analytics ภายหลังได้
สรุป
Monitoring Solar Farm ที่ดีต้องเริ่มจาก measurement และ operational question ไม่ใช่เริ่มจากเลือก Dashboard
โครงสร้างขั้นต่ำที่ควรคิดให้ครบคือ Sensor/Inverter/Meter → Logger/Gateway → Network → Historian → KPI/Alarm → O&M Workflow พร้อม data ownership และ export path ที่ชัดเจน เมื่อรากฐานนี้ดีจึงค่อยต่อยอด analytics, anomaly detection หรือ predictive maintenance ได้อย่างมีความหมาย